
RAI Data / Usługi / Modele uczenia maszynowego
Przewiduj właściwości produktu
i wyniki procesu na podstawie danych
Właściwości gotowego produktu często poznajemy dopiero po jego wytworzeniu i zbadaniu. Wcześniej znamy użyte surowce i warunki produkcji, ale trudno na tej podstawie obliczyć, jaki będzie końcowy wynik. Modele predykcyjne pomagają przewidywać te właściwości na podstawie danych z wcześniejszej produkcji.
Jak model wykorzystuje dane produkcyjne
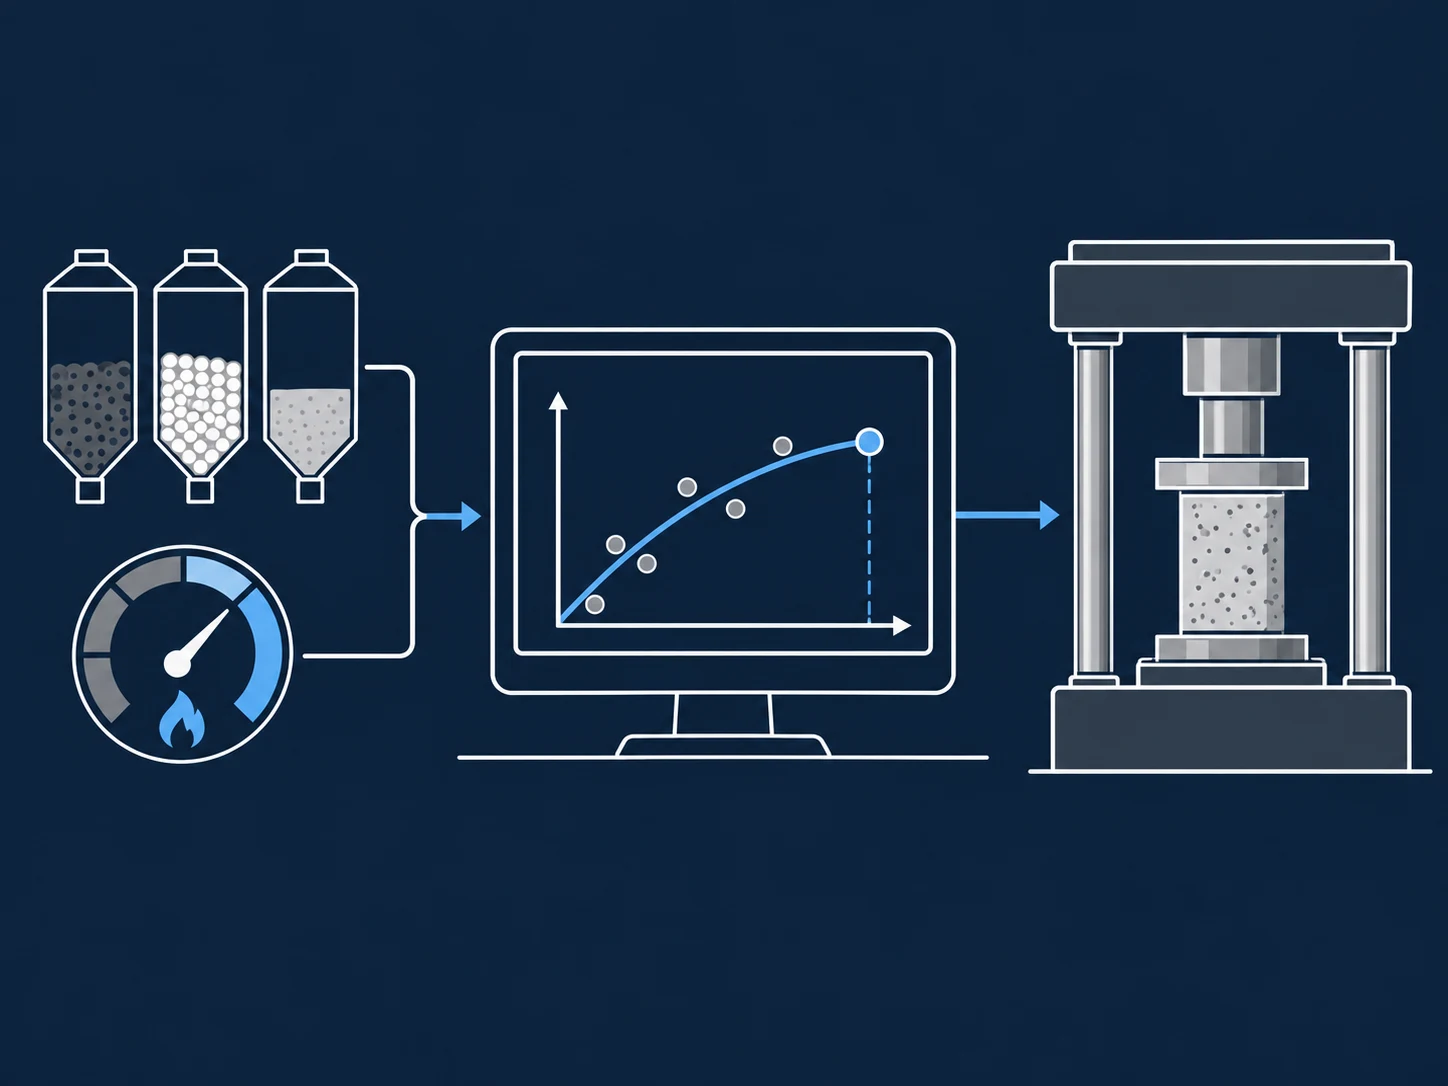
Do budowy modelu wykorzystujemy zapisy wcześniejszej produkcji, łącząc informacje o surowcach i przebiegu procesu z wynikami badań gotowego produktu. W przypadku mieszanek mogą to być właściwości poszczególnych składników, ich udziały procentowe oraz warunki, w jakich przetwarzano mieszaninę. Każda partia, dla której znamy te informacje i zmierzone parametry produktu, dostarcza przykładu do uczenia modelu. Na podstawie wielu takich przykładów model uczy się zależności między danymi opisującymi produkcję a jej wynikiem. Następnie sprawdzamy jego prognozy na osobnych danych, których nie wykorzystaliśmy podczas uczenia. Pozwala to ocenić, z jaką dokładnością można przewidywać właściwości kolejnych produktów.
Dlaczego wynik procesu trudno obliczyć
Dobrze widać ten problem w procesach mieszankowych. Łączymy surowce w określonych proporcjach, a następnie poddajemy mieszaninę procesowi technologicznemu. Pod jego wpływem może ona zmienić się w produkt, który znacznie różni się od początkowej mieszanki. Powstają nowe właściwości fizyczne i chemiczne, a parametry gotowego produktu trudno wyznaczyć bezpośrednio z właściwości poszczególnych składników i ich udziałów procentowych.
Wiemy, że skład i warunki procesu wpływają na wynik, jednak opisanie tych zależności bywa bardzo trudne. Często brakuje wzoru lub metody obliczeniowej, która pozwoliłaby przewidzieć interesujący nas parametr z dokładnością potrzebną w produkcji. Technolog musi wtedy korzystać ze swojego doświadczenia, prób produkcyjnych i wyników badań.
Czego model uczy się z danych produkcyjnych
W RAI Data budujemy modele, które pomagają uzupełnić tę wiedzę. Wykorzystujemy dane opisujące surowce, receptury, przebieg procesu oraz zmierzone właściwości gotowych produktów. Na ich podstawie uczymy model zależności między tym, co trafia do procesu, a tym, co z niego wychodzi. Dla kolejnej receptury i określonych warunków produkcji model może następnie przewidzieć parametry produktu, zanim poznamy wyniki jego badań.
Takie prognozy mogą wspierać dobór receptury, ocenę zmian w procesie i optymalizację produkcji. Choć szczególnie skupiamy się na mieszankach, podobne podejście stosujemy również w innych procesach, w których trudno obliczyć właściwości produktu, a dostępne dane pozwalają szukać zależności.
Regresja: przewidywanie wartości
Model regresyjny przewiduje wynik w postaci liczby, na przykład wytrzymałość produktu, zużycie energii lub czas procesu. Wykorzystuje do tego informacje, które znamy już w chwili wykonywania prognozy. Technolog może więc sprawdzić, jak zmiana receptury lub ustawień procesu wpłynie na przewidywane właściwości produktu, i wybrać warianty, które warto przetestować na produkcji.
Klasyfikacja: przypisywanie do kategorii
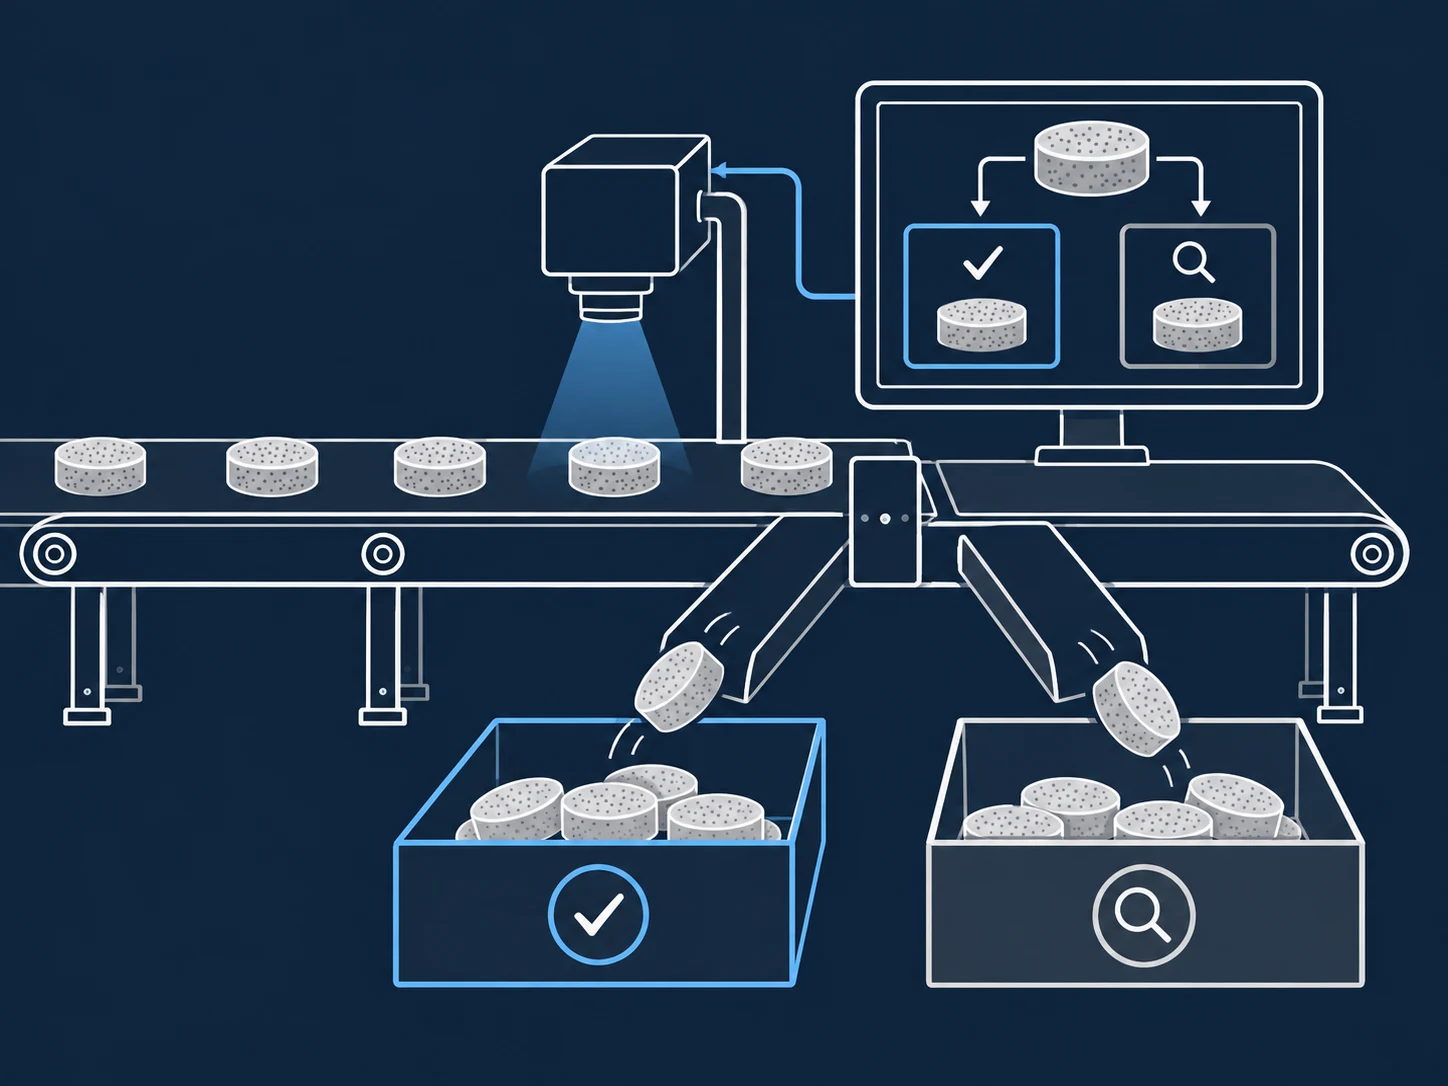
Model klasyfikacyjny pomaga określić, do której grupy należy dany przypadek. Może na przykład przewidywać, czy produkt spełni wymagania jakościowe, albo wskazywać partie z podwyższonym ryzykiem niezgodności. W ten sposób pomaga wybrać przypadki wymagające dodatkowej kontroli i wcześniej zwrócić uwagę na możliwy problem.
Modele dla różnych branż
Choć szczególnie skupiamy się na procesach mieszankowych, budujemy również modele dla innych procesów produkcyjnych i zadań biznesowych. Punktem wyjścia jest konkretne pytanie: co chcemy przewidywać lub rozpoznawać? Następnie sprawdzamy, czy dostępne dane opisują czynniki wpływające na wynik i zawierają przykłady, na których można nauczyć model. Na tej podstawie dobieramy rozwiązanie do zadania.
Jak sprawdzamy wiarygodność modelu
Prognozy modelu porównujemy z rzeczywistymi wynikami dla przypadków, których nie wykorzystaliśmy podczas uczenia. Sprawdzamy, jak duże błędy popełnia i czy daje lepsze wyniki niż prostsze metody, na przykład przyjęcie średniej z wcześniejszych pomiarów. Oceniamy też, czy jego dokładność wystarcza do decyzji, którą ma wspierać. Użytkownik powinien wiedzieć, w jakich warunkach może korzystać z prognozy i kiedy potrzebna jest dodatkowa weryfikacja.
Źródła i dalsza lektura
- scikit-learn: ocena modeli
Podział danych do uczenia i oceny, również dla kolejnych okresów i grup obserwacji.
- scikit-learn: błędy w przygotowaniu danych
Jak uniknąć wykorzystania w ocenie informacji niedostępnych w chwili prognozowania.
Twoje dane mogą pracować
na lepsze wyniki.
Sprawdzimy, jak wykorzystać dane Twojej firmy, aby ograniczyć koszty, usprawnić produkcję lub poprawić jakość.